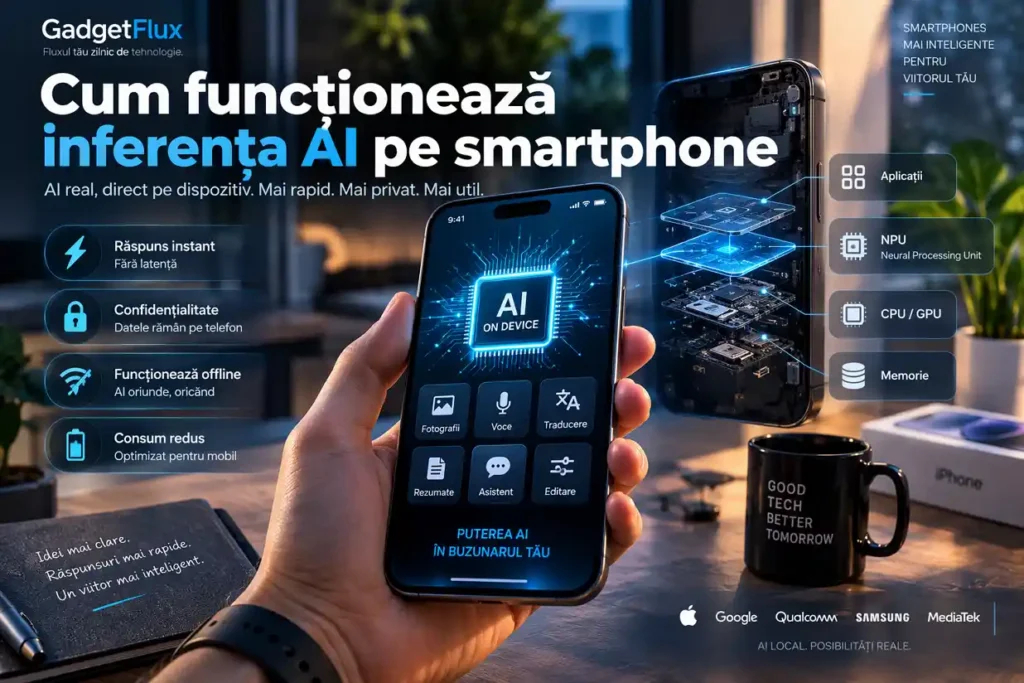
Descoperă cum smartphone-urile procesează AI local, fără dependență permanentă de cloud.
Inteligența artificială nu mai este limitată la centre de date și servicii online. În ultimii ani, producători precum Apple, Google, Samsung și Qualcomm au început să ruleze tot mai multe funcții AI direct pe dispozitivele utilizatorilor. Această schimbare permite procesarea locală a datelor, fără a trimite permanent informațiile către servere externe.
Conceptul care face posibil acest lucru se numește inferență AI. Deși pare un termen tehnic, inferența stă la baza unor funcții pe care milioane de oameni le folosesc deja zilnic pe smartphone.
Ce este inferența AI?
În inteligența artificială există două etape principale:
Antrenarea modelului
În această etapă, modelul AI învață folosind cantități uriașe de date și resurse de calcul.
Procesul necesită:
- centre de date;
- GPU-uri performante;
- consum ridicat de energie;
- costuri foarte mari.
Inferența modelului
Inferența reprezintă utilizarea modelului deja antrenat pentru a genera rezultate.
Practic, atunci când:
- dictezi un mesaj;
- traduci un text;
- utilizezi funcția de ștergere a obiectelor dintr-o fotografie;
- generezi un rezumat;
telefonul execută inferență AI.
Modelul a fost antrenat anterior într-un centru de date, însă rezultatul este generat direct pe dispozitiv.
De ce nu toate funcțiile AI rulează în cloud?
Mult timp, procesarea AI s-a bazat aproape exclusiv pe cloud.
Fluxul obișnuit era:
- utilizatorul trimite date;
- datele sunt încărcate pe server;
- modelul procesează informațiile;
- rezultatul este returnat.
Această abordare funcționează, dar aduce și limitări.
Latența
Fiecare solicitare trebuie să călătorească până la un server și înapoi.
Pentru sarcini precum:
- traducerea în timp real;
- recunoașterea vocală;
- editarea imaginilor;
chiar și câteva sute de milisecunde pot face diferența.
Confidențialitatea
Fotografiile, mesajele și documentele utilizatorilor pot conține informații sensibile.
Procesarea locală reduce cantitatea de date care părăsesc dispozitivul.
Dependenta de internet
Fără internet, multe funcții cloud devin inutile.
Inferența locală permite utilizarea unor funcții AI chiar și în modul offline.
Cum funcționează inferența AI direct pe smartphone?
Procesul este mai simplu decât pare.
Pasul 1: Colectarea informațiilor
Telefonul primește:
- text;
- voce;
- imagini;
- videoclipuri;
- comenzi ale utilizatorului.
Pasul 2: Procesarea locală
Modelul AI rulează pe hardware-ul dispozitivului.
Procesarea este realizată de componente specializate precum:
- NPU (Neural Processing Unit);
- GPU;
- procesoare dedicate AI.
Pasul 3: Generarea rezultatului
Modelul furnizează imediat răspunsul.
Acesta poate fi:
- o traducere;
- o transcriere;
- un rezumat;
- o recomandare;
- o modificare a unei imagini.
Totul fără a trimite neapărat datele către cloud.
Ce este un NPU și de ce contează?
NPU vine de la Neural Processing Unit.
Este un procesor specializat pentru operațiuni de inteligență artificială.
Spre deosebire de CPU-urile tradiționale, NPU-urile sunt optimizate pentru:
- procesare paralelă;
- consum redus de energie;
- operații matematice specifice AI.
Aceste componente permit rularea modelelor moderne fără impact major asupra bateriei.
Exemple de hardware dedicat AI
Apple Neural Engine
Apple utilizează Neural Engine în procesoarele Apple Silicon.
Acesta contribuie la:
- procesarea imaginilor;
- recunoașterea vocală;
- funcțiile Apple Intelligence;
- clasificarea conținutului.
Google Tensor
Procesoarele Tensor sunt dezvoltate special pentru dispozitivele Pixel.
Acestea accelerează:
- recunoașterea limbajului natural;
- traducerea în timp real;
- funcțiile Gemini Nano.
Qualcomm Snapdragon AI Engine
Procesoarele Snapdragon includ acceleratoare dedicate inteligenței artificiale.
Aceste tehnologii sunt utilizate de numeroși producători Android.
Pentru mai multe informații despre procesoarele AI dezvoltate de Qualcomm, poți consulta documentația disponibilă pe Qualcomm: https://www.qualcomm.com/
Cum folosește Apple Intelligence inferența locală?
Apple Intelligence utilizează o abordare hibridă.
Numeroase operațiuni sunt efectuate direct pe dispozitiv:
- rezumate ale notificărilor;
- rescrierea textelor;
- organizarea informațiilor;
- procesarea imaginilor.
Doar sarcinile foarte complexe sunt trimise către infrastructura Private Cloud Compute.
Această abordare urmărește să ofere un nivel ridicat de confidențialitate.
Află mai multe detalii despre funcțiile Apple Intelligence.
Gemini Nano și telefoanele Pixel
Google a dezvoltat Gemini Nano ca versiune compactă a modelului Gemini.
Scopul principal este rularea direct pe smartphone.
Gemini Nano poate gestiona:
- rezumate;
- transcrieri;
- răspunsuri inteligente;
- clasificarea informațiilor.
Această abordare reprezintă unul dintre cele mai importante exemple moderne de inferență AI locală.
Află mai multe informații despre cercetările Google în domeniul inteligenței artificiale.
Legătura cu Edge AI
Conceptul de inferență locală este strâns legat de Edge AI.
În articolul Edge AI: de ce procesează datele local am explicat cum dispozitivele moderne pot executa sarcini AI direct pe hardware-ul propriu, fără dependență permanentă de cloud:
Practic, inferența pe smartphone reprezintă una dintre cele mai populare aplicații ale Edge AI.
Pot funcționa agenții AI pe smartphone?
Da, iar această direcție devine tot mai importantă.
Pe măsură ce procesoarele devin mai performante, agenții AI pot executa local tot mai multe sarcini.
Dacă vrei să înțelegi mai bine diferența dintre un chatbot și un agent AI autonom, poți citi și:
AI Agents vs Chatbots: care este diferența reală?
În viitor, smartphone-ul ar putea deveni principalul dispozitiv folosit pentru agenți AI personali.
Rolul memoriei AI pe smartphone
Pentru ca răspunsurile să fie relevante, sistemele AI trebuie să poată utiliza context și preferințe.
Acest lucru este posibil datorită mecanismelor moderne de memorie AI.
Am explicat acest proces în articolul:
Cum funcționează memoria AI pe termen lung
Combinarea memoriei AI cu inferența locală poate duce la asistenți personali mai rapizi și mai eficienți.
Care sunt limitările inferenței locale?
Deși avantajele sunt evidente, există și limitări.
Puterea de calcul
Un smartphone nu poate egala un centru de date cu mii de GPU-uri.
Spațiul disponibil
Modelele foarte mari ocupă mult spațiu de stocare.
Consumul energetic
Funcțiile AI complexe pot afecta autonomia bateriei.
Costul hardware-ului
Procesoarele AI performante cresc costul dispozitivelor moderne.
Viitorul AI pe smartphone
Industria se îndreaptă rapid către dispozitive capabile să ruleze modele AI tot mai avansate local.
În următorii ani este posibil să vedem:
- asistenți AI complet offline;
- traduceri instantanee fără internet;
- editare foto și video locală;
- procesare multimodală;
- agenți AI personali integrați în sistemul de operare.
Acest lucru ar putea transforma smartphone-ul într-unul dintre cele mai importante dispozitive pentru utilizarea inteligenței artificiale.
Concluzie
Inferența AI reprezintă tehnologia care permite smartphone-urilor moderne să execute sarcini inteligente fără a depinde permanent de cloud. Folosind NPU-uri dedicate și modele optimizate, dispozitivele actuale pot procesa imagini, voce și text direct pe telefon, oferind mai multă viteză, confidențialitate și autonomie. Pe măsură ce Edge AI, memoria contextuală și agenții AI evoluează, inferența locală va deveni o componentă esențială a experienței mobile moderne.

